Guía de prompts de Seedream 4.5: patrones que funcionan
Escrito por Clement
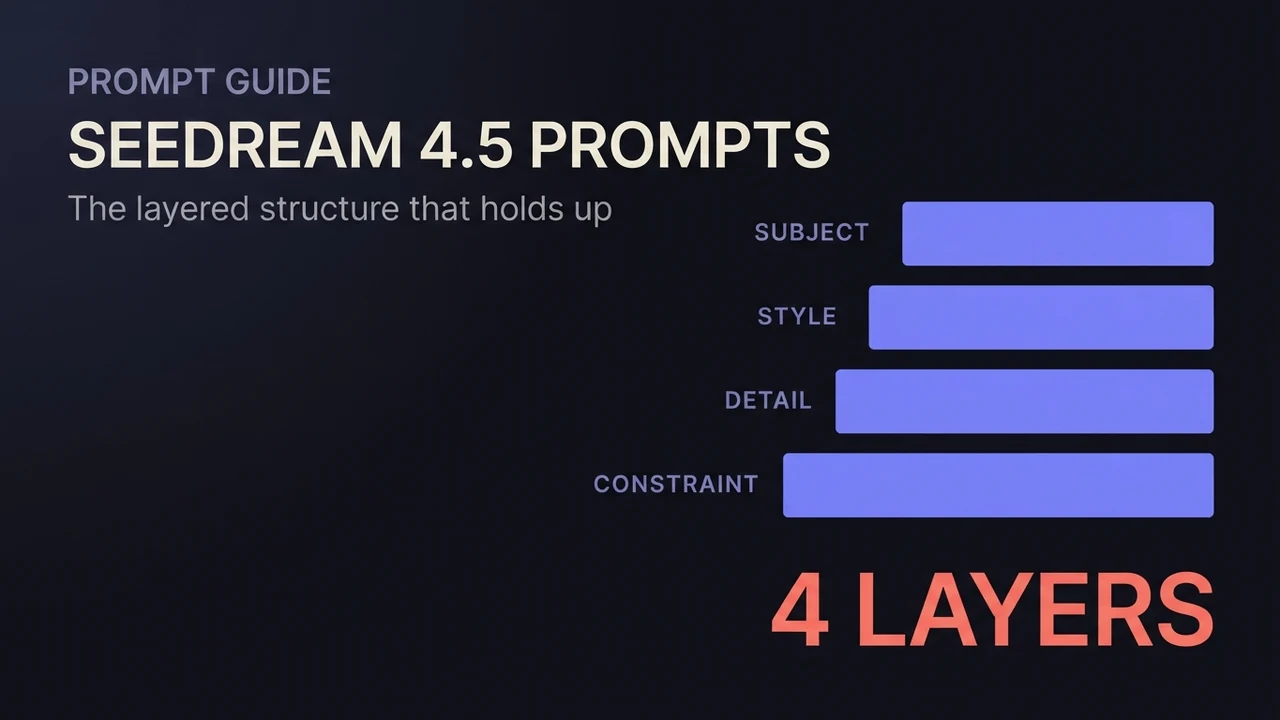
La mayoría de los prompts de Seedream 4.5 fallan de la misma manera: describen una escena cuando el modelo necesitaba una instrucción, o dan una instrucción tan vaga que el modelo tiene que adivinar. La solución no es la creatividad, es la estructura, y se aprende en una sola sentada.
Esta guía es el complemento de redacción de prompts de nuestro paso a paso de Seedream 4.5. Aquella cubre el flujo de trabajo y los ajustes; esta se centra en las palabras: cómo construir por capas un prompt de text-to-image, cómo redactar una edición para que el modelo cambie una sola cosa y conserve el resto, y cómo dirigir una fusión de varias imágenes para que cada entrada aporte lo que pensabas.
La regla que gobierna todo prompt de edición
Seedream 4.5 trata tu imagen de entrada como la base y tu prompt como la diferencia. Ese único hecho decide cómo conviene escribir. Nombra lo que cambia. Describe lo que se mantiene solo cuando no es obvio por el contexto. En cuanto vuelves a describir toda la escena, invitas al modelo a regenerar cosas que querías intactas.
Lo probamos directamente, edición frente a redescripción, y la diferencia no fue sutil: "keep the product, change only the background" (conserva el producto, cambia solo el fondo) conservó la fuente mucho mejor que una descripción nueva de la misma escena. La versión redescrita se veía plausible por sí sola. Junto a la fuente, el producto se había desviado.
La estructura por capas para text-to-image
Cuando no hay imagen de entrada, construye el prompt por capas, en este orden: primero sujeto y pose, luego estilo y paleta de color, luego escenario e iluminación, y por último el encuadre de cámara. El orden importa porque refleja lo que el modelo pesa más. Una indicación de cámara metida al principio te cuesta fidelidad del sujeto al final.
Este es el mismo prompt construido capa por capa. Sujeto: "a woman in her 30s mid-laugh, head tilted back" (una mujer de unos 30 años en plena risa, con la cabeza echada hacia atrás). Estilo: "shot like a premium lifestyle editorial, warm muted palette" (fotografiada como un editorial lifestyle premium, paleta cálida y apagada). Escenario: "in a sunlit kitchen, late afternoon light through the window" (en una cocina soleada, luz de última hora de la tarde por la ventana). Cámara: "waist-up framing, shallow depth of field" (encuadre de cintura para arriba, poca profundidad de campo). Cada capa acota el espacio sin chocar con la anterior.
Mantén un solo punto focal. Si necesitas texto legible o un rostro nítido en la imagen, dilo con claridad y dale espacio. Los puntos focales que compiten son el lugar donde el famoso renderizado de texto y rostros de este modelo empieza a tambalearse.
Construye un prompt de edición en cuatro pasadas
Para trabajo de image-to-image, escribe el prompt en este orden. Lleva treinta segundos y ahorra rondas enteras de regeneración.
- 1
Nombra el cambio único
Empieza por el verbo y el objetivo: "replace the background with...", "change the outfit to...", "restyle the lighting as...". Una edición por ronda funciona mejor que tres ediciones apiladas que se pelean entre sí.
- 2
Fija lo que debe sobrevivir
Añade la cláusula de conservación solo para lo que está en riesgo y no es obvio: "keep the product, its label, and the lighting exactly as shown." No hace falta listarlo todo. Lista lo que la edición podría alterar razonablemente.
- 3
Cita cualquier texto exacto
Si una etiqueta, un letrero o un titular debe leerse de una forma concreta, cita la cadena exacta en el prompt. El texto parafraseado es la fuente más común de letras deformadas. Las cadenas citadas son lo que este modelo hace especialmente bien.
- 4
Revisa la coherencia y también la calidad
Cuando llegue el resultado, compara los elementos conservados con la fuente antes de admirar los nuevos. Un resultado nítido y pulido puede haberse desviado en silencio del original. La coherencia es para lo que está ajustado este modelo, así que exígesela.
Plantillas listas para copiar
Plantillas para los trabajos más comunes. Cambia las partes entre corchetes y conserva la forma. Las plantillas de prompt se mantienen en inglés para que puedas copiarlas tal cual.
- Cambio de fondo
- "Replace the background with [new setting]. Keep the [subject], its [key detail], and the lighting exactly as shown."
- Cambio de ropa
- "Change the outfit to [new outfit]. Keep the face, pose, and framing unchanged."
- Transferencia de estilo
- "Restyle this image as [style]. Preserve the composition and the subject's identity."
- Fusión de dos imágenes
- "Use the person from image 1 and the jacket from image 2. Place the person in [setting], wearing the jacket, lit by [lighting]."
- Texto en la imagen
- "A [surface] that reads \"[exact string]\" in [style of lettering]. Make the text the focal point."
Recibe los nuevos archivos de prompts primero
Un email cuando publicamos un nuevo archivo de prompts probado o una guía de modelo. Prompts probados en producción, no teoría. Sin spam, cancela cuando quieras.
Cómo dirigir una fusión de varias imágenes
Indica de forma explícita qué aporta cada entrada: qué imagen pone el sujeto, cuál pone un accesorio o un estilo, y cómo se colocan juntos en la nueva composición. El modelo responde a instrucciones precisas y por capas, y la fusión es donde esa disciplina rinde más.
Pocas imágenes limpias valen más que muchas mediocres. Dos o tres imágenes nítidas que aportan un elemento cada una se fusionan con más fiabilidad que un montón donde varias casi no contribuyen. Mantén también una iluminación razonablemente pareja entre las entradas: una foto de estudio junto a una foto oscura de móvil obliga al modelo a reconciliar dos calidades de material, y ahí es donde las fusiones parecen ensambladas en lugar de fotografiadas como una sola escena.
Cuando un elemento de la fusión se ve mal y el resto está bien, no reescribas todo el prompt. Revisa primero la imagen fuente de ese elemento y afina solo la instrucción que se refiere a él.
Dos personajes distintos en el mismo encuadre
Pedir dos personajes concretos en una sola imagen es un problema distinto de la fusión, y falla de una manera característica: el modelo los promedia. Pides dos personas y obtienes el mismo rostro dos veces, o una pareja que comparte un color de pelo que pertenece solo a uno. El nombre técnico es attribute bleed (contaminación de atributos), y ocurre porque el modelo mantiene ambas descripciones en el mismo presupuesto de atención sin un motivo fuerte para separarlas.
La solución es darle ese motivo. Ancla cada personaje a una posición distinta del encuadre y descríbelo como una unidad, en lugar de listar todos los rasgos de ambos esperando que caigan en el sujeto correcto. "On the left, a tall woman with short black hair in a red jacket; on the right, a shorter man with blond curls in a grey coat" (a la izquierda, una mujer alta de pelo negro corto con chaqueta roja; a la derecha, un hombre más bajo de rizos rubios con abrigo gris) le da al modelo dos huecos espaciales para rellenar por separado. La misma descripción escrita como lista plana de cinco rasgos le da un solo montón mezclado.
Las LoRA de personaje lo empeoran en lugar de ayudar. Cargar dos LoRA de personaje a la vez es la forma más fiable de obtener una mezcla de ambos, porque cada una tira de toda la imagen hacia su propio sujeto. Si necesitas dos personajes entrenados concretos juntos, generarlos por separado y componerlos después suele dar menos trabajo que pelear con la mezcla.
La calidad de la propia LoRA importa aquí más de lo que la mayoría espera. Una LoRA de baja calidad renderiza peor a su sujeto y, encima, degrada activamente la capacidad del modelo para seguir el resto del prompt. Los detalles de los dos personajes se mezclan entre sí, y las instrucciones que normalmente se cumplen bien empiezan a fallar. Una LoRA bien entrenada mantiene a su sujeto y deja que el resto del prompt se comporte con normalidad; una débil se contagia a todo lo que la rodea.
Cuando el prompt no es el problema
Un resultado borroso o con pocos detalles en una edición suele deberse a la imagen de entrada, no a la redacción. El modelo puede afinar y cambiar el estilo, pero no puede inventar un detalle que no existe en ningún lugar de la fuente. Antes de reescribir un prompt por cuarta vez, mira con atención lo que le diste.
Pasa lo mismo con los rostros en la fusión: si el rostro de origen es pequeño, está borroso o medio de perfil, ninguna redacción lo salva. Cambia la entrada por una más limpia y el "problema de prompt" suele desaparecer.
Preguntas frecuentes
- ¿Cómo genero dos personajes distintos en una misma imagen?
- Dale a cada personaje su propia posición en el encuadre y descríbelo como una unidad, en lugar de listar todos los rasgos de ambos a la vez: "on the left, a tall woman with short black hair; on the right, a shorter man with blond curls". Listar rasgos de forma plana invita a la contaminación de atributos: el modelo promedia a los dos en un solo aspecto o les da los rasgos del otro. Dos LoRA de personaje cargadas a la vez empeoran la mezcla. Para dos personajes entrenados concretos, suele ser más rápido generarlos por separado y componer el resultado.
- ¿Cómo es un buen prompt de Seedream 4.5?
- Para text-to-image: por capas y en orden: sujeto y pose, estilo y paleta, escenario e iluminación, encuadre de cámara. Para ediciones: una instrucción que nombra el cambio único, más una cláusula corta de conservación para lo que esté en riesgo. Ambas formas son cortas. La precisión gana a la longitud.
- ¿Cómo edito una imagen sin que Seedream cambie todo?
- Escribe la diferencia, no la escena: "change only the background to a beach at sunset, keep the product and lighting as shown." Volver a describir la escena completa es la primera causa de desviaciones no deseadas.
- ¿Seedream 4.5 puede renderizar texto exacto?
- Sí, y sorprendentemente bien, pero solo si citas la cadena exacta en el prompt y la mantienes como un punto focal claro. Parafrasear el texto o enterrarlo entre sujetos que compiten produce letras deformadas.
- ¿Cuántas imágenes de entrada debo usar para una fusión?
- Dos o tres nítidas, cada una aportando un elemento. Más entradas no añaden control: lo diluyen. La calidad y la claridad de cada fuente importan más que la cantidad.
Seguir leyendo
Cómo usar Seedream 4.5 para generar imágenes con IA
Una guía práctica de Seedream 4.5 de ByteDance: cómo funcionan sus modos text-to-image e image-to-image (fusión de varias imágenes), cómo referenciar imágenes de entrada en un prompt, los ajustes de resolución y de lote que importan, y cómo conseguir resultados coherentes y con mucho detalle.
How to use Dola-Seedream-5.0-lite for AI image generation
A practical guide to Dola-Seedream-5.0-lite (model ID seedream-5-0-260128): a text- and image-input model with web-connected retrieval, strong reference consistency, and accurate instruction following. Covers how to prompt it, combine reference images, and pick the right pricing tier.
How to use Z-Image for AI image generation
A practical guide to Z-Image (z-image-turbo): a fast, lightweight text-to-image model with clean English and Chinese text rendering. Covers the resolutions that work best, how to write a prompt it renders faithfully, and the settings that decide speed versus quality.
How to use FLUX.2 [klein] for AI anime-style images
A practical guide to FLUX.2 [klein]: a small, fast model that restyles a photo or photoreal image into anime/manga art. Covers how the image-to-image transform works, how to write a style prompt it responds to, and the mistakes that break the pose or composition.
Modelos relacionados
Recibe los nuevos archivos de prompts primero
Un email cuando publicamos un nuevo archivo de prompts probado o una guía de modelo. Prompts probados en producción, no teoría. Sin spam, cancela cuando quieras.